Коротко
- Распознать текст – треть задачи. Остальное – понять структуру документа и проверить результат.
- У каждого поля есть уровень уверенности: уверенное уходит в систему, сомнительное – человеку.
- Качество меряют на документах из реального потока, а не на примерах для демо.
Где на самом деле ошибки
Когда мы разбираем поток документов заказчика, ошибки почти никогда не сидят там, где их ждут. Сам текст современные модели распознают хорошо. Ломается другое:
- Структура. В одном счёте сумма с НДС стоит в итоговой строке, в другом – в таблице, в третьем – только прописью. Модель находит число, но не всегда то.
- Качество источника. Фото с телефона под углом, печать поверх реквизитов, скан третьей копии. Каждый такой случай – отдельный класс ошибок.
- Длинный хвост. Основную часть потока составляют несколько типовых видов документов. Остальное – редкие формы, и именно в них прячется большинство проблем.
- Смысл, а не текст. В договоре нужно найти не слово «срок», а дату окончания обязательства с учётом допсоглашений. Это уже задача на понимание.
Конвейер вместо одной модели
Надёжное извлечение – это несколько шагов, и у каждого своя проверка:
- Классификация. Сначала понять, что за документ перед нами, и отправить его по нужному маршруту.
- Распознавание и структура. Текст, таблицы, расположение блоков на странице.
- Извлечение полей. Языковая модель получает документ и чёткую схему: какие поля нужны, в каком формате и что делать, если поля нет.
- Проверки. Арифметика (сумма строк равна итогу), форматы (ИНН, БИК, даты), сверка со справочниками и учётной системой.
Последний шаг недооценивают чаще всего. Простые правила ловят заметную часть ошибок модели и почти ничего не стоят.
Модель должна не только ответить, но и сказать, насколько она уверена.
Порог уверенности и человек в контуре
У каждого извлечённого поля есть оценка уверенности: из самой модели, из проверок и из того, насколько документ похож на уже знакомые. Поля выше порога уходят в систему автоматически, ниже – попадают к сотруднику. Причём не весь документ целиком, а конкретные сомнительные места с подсветкой.
Порог – решение бизнесовое, а не техническое. Чем он выше, тем меньше ошибок и тем больше ручной работы. Мы подбираем его вместе с заказчиком на данных пилота, исходя из стоимости ошибки: для платёжных реквизитов порог один, для поля «комментарий» – совсем другой.
Как мерить качество
Главная ошибка – мерить на примерах, собранных для демо. Мы берём выборку из реального потока за последние месяцы, включая плохие сканы и редкие типы, и размечаем её вручную. Эта отложенная выборка не участвует в настройке и служит единственным честным мерилом.
Меряем не «точность модели» вообще, а по каждому полю и по каждому типу документа отдельно. Средняя цифра может выглядеть отлично и скрывать, что ключевое поле в одном из типов документов извлекается плохо.
Что меняется для людей
Хорошо собранный контур не убирает людей из процесса – он меняет их работу. Вместо набора данных с нуля сотрудник проверяет сомнительные места и разбирает редкие случаи. По мере накопления исправлений доля автоматической обработки растёт, но только если в процессе предусмотрен путь, по которому исправления возвращаются в систему.
Не только счета
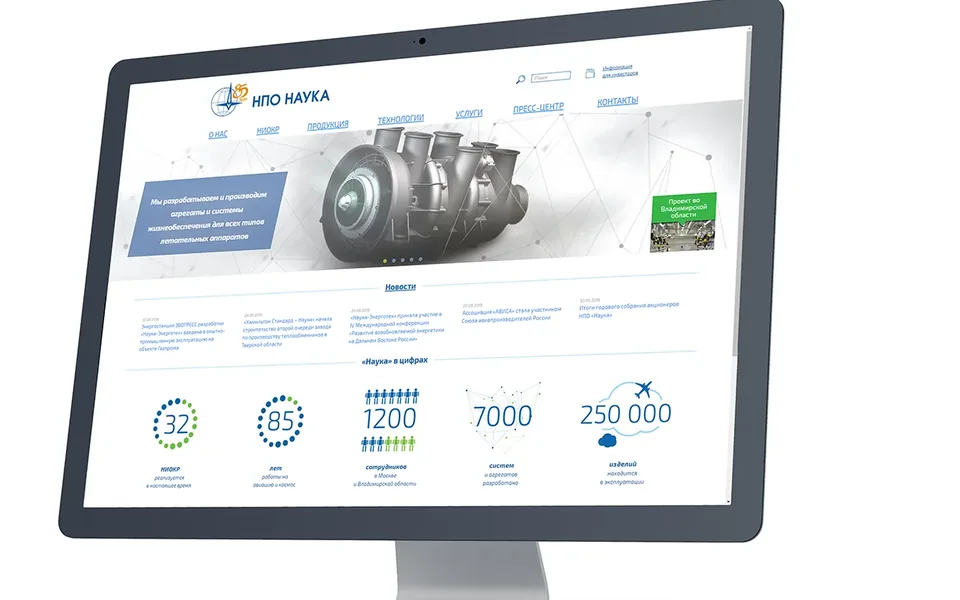
Тот же подход работает с большими массивами технической документации. Для НПО «Наука» сотни страниц техдокументации разобрали с помощью языковой модели: она предложила структуру каталога и черновики описаний продукции, а инженеры предприятия их выверили. Модель взяла на себя объём, люди – ответственность за точность
Кейс · Сайт · LLM
НПО «Наука»
Каталог продукции собран из сотен страниц техдокументации – с проверкой инженерами предприятия